

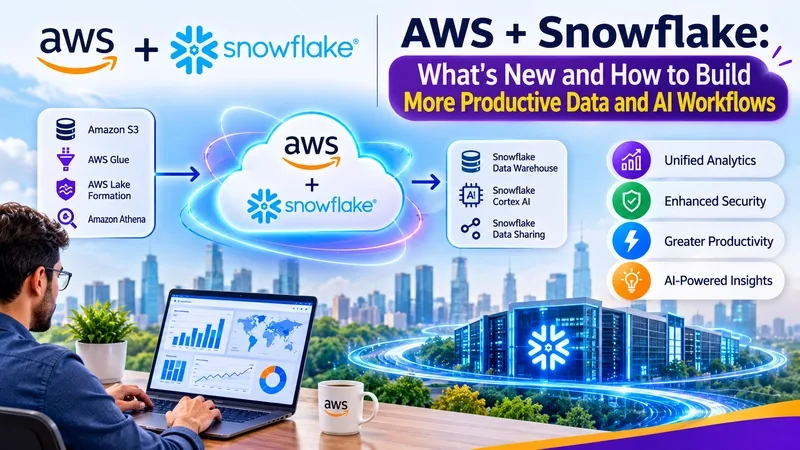

AWS Glue ve Snowflake ile Modern Veri Pipeline'ı Kurmak
Günümüzde veri platformları sadece bir veritabanından diğerine veri taşımaktan ibaret değil. Ölçeklenebilir pipeline'lar, kontrollü veri erişimi, açık tablo formatları ve AI destekli analizler gerekiyor. AWS ve Snowflake bu ekosistemde önemli rol oynuyor ve iyi haber şu: tüm verini tek bir yere taşımak zorunda değilsin.
AWS S3'te depolanan verilerini Snowflake'te analiz etmek istiyorsan, AWS Glue aradaki köprü görevi yapıyor. Glue, ETL (Extract-Transform-Load) işlerini otomatikleştiriyor; S3'teki ham veriyi temizliyor, dönüştürüyor ve Snowflake'e gönderiyor. Pratik olarak, bir satış veri seti alıp S3'ten çekerek, Glue ile işleyip Snowflake'e yüklemek birkaç adımda yapılabiliyor.
Bu kombinasyonun gücü açık tablo formatlarında yatıyor. Apache Iceberg gibi formatlar, S3 ve Snowflake arasında veri tutarlılığını sağlıyor. Bir taraf değişiklik yapsa, diğer taraf da bunu anlıyor. Ayrıca Snowflake'in Cortex özelliği, yüklediğin veriye doğrudan AI modellerini uygulayabiliyor, SQL sorgusu yazarak LLM çağırabiliyor, yani veri analizi ile yapay zeka aynı ortamda birleşiyor.
Praktik açıdan bakınca, AWS'de zaten depolanan verini Snowflake'in güçlü analiz ve veri paylaşım yeteneklerinden yararlanmak için taşımak maliyetli ve gereksiz. Glue ile otomatik bir boru hattı kurup, Snowflake'te sorgulamak daha akıllıca. Özellikle kuruluşlar veri silo'larını kırmak ve farklı takımların aynı veriyi güvenle kullanmasını istediğinde bu yaklaşım çok değerli oluyor.
Detaylı örnek ve adım adım kurulum için orijinal makaleyi inceleyebilirsin. Özellikle Glue job'ı yazarken Python ya da Scala kullanabildiğini, Iceberg ile veri versiyonlaması yapabildiğini ve Cortex ile SQL içinden AI çağırabildğini göreceksin.
0 yorum