


Belgelerden Yanıt Veren Arşiv: Kaynaklarını Gösteren AI
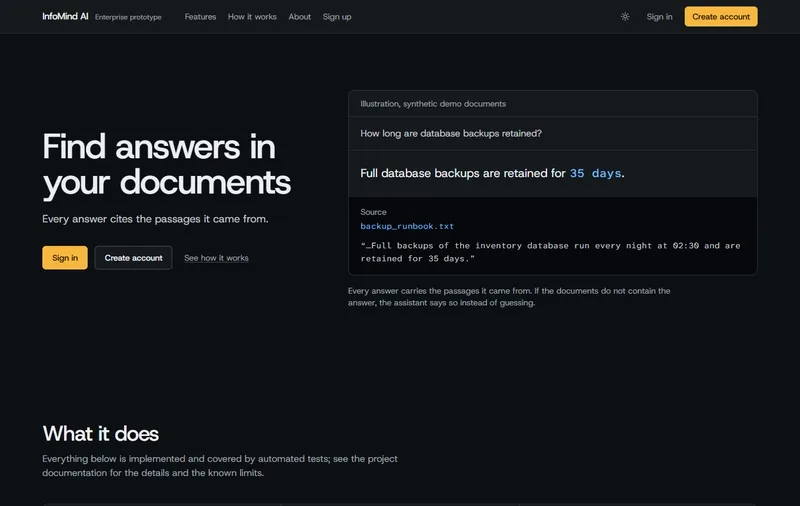
Abhay Singh'in Hacktoberfest'e sunduğu InfoMind AI Enterprise, yapay zekanın en yaygın sorununu çözmek için tasarlanmış: halüsinasyon, yani uydurma. Sistem yüklediğin belgelere (PDF, Word, Excel, CSV, metin) bakıyor, onları parçalara ayırıyor, anahtar kelime ve anlam bazında indeksliyor, sonra soruların cevaplarını sadece arşivde gerçekten yazılı olanlardan veriyor. Cevap bulamıyorsa açık söylüyor: "Mevcut belgeler bu soruyu güvenilir biçimde yanıtlamak için yeterli kanıt içermiyor."
Teknolojik yığın sağlam: React ve TypeScript ön yüzde, FastAPI ve PostgreSQL arkada, vektör araması için Qdrant, dil modeli olarak Ollama kullanılıyor. Belgeler otomatik kategorize ediliyor (scikit-learn ile), emin olmayan durumlar insan incelemesine gidiyor. Her yanıt, çekilen tam pasajlarla birlikte geliyor, bu da belge uyumluluğu ve denetlenebilirlik gerektiren işlerde kritik.
Projenin ruhunda bir farkındalık var: çoğu chatbot kullanıcıyı yanıltmaktan çekinmiyor, ama kurumsal arşivler, hukuki belgeler ya da tıbbi kayıtlar için bu kabul edilemez. InfoMind "evet" ya da "hayır" yerine "bilmiyorum" diyebilen bir sistem. Açık model (Ollama) seçimi de önemli, kapalı API'lere bağımlı olmadan kendi sunucularında çalışabiliyor.
Bu tür araçlar özellikle uyum gerektiren sektörlerde (finans, hukuk, sağlık) değerli. Belgelerin kaynağını göstermek sadece güven meselesi değil, yasal sorumluluk meselesi de.

0 yorum