


Frontier modelleri seçerken benchmark puanına bakma
Ekim 2026'de Gemini 4 Argon halka açıldı ve hemen arkasından Claude Opus 5.5, GPT-6.1 Sol, Claude Sonnet 5.5 gibi modeller geldi. Yalnızca iki ayda 49 isimli model, bu sene içinde 123 model çıktı. Hangisini seçeceksin?
Benchmark puanlarına baksan yanılabilirsin. GPT-6.1 Sol puanda 52 alıyor, görev başına 0,72 dolar. GPT-6 Astra puanda 53 alıyor ama 3,26 dolar. Claude Opus 5.5 görev başına 5,98 dolar, Claude Fable 5.1 ise 7,63 dolar, ikisi de puanda 53. Bir puan fark, 5 ile 11 kat arasında maliyet farkı demek. GPT-6.1 Sol bile GPT-6 Sol'un yerini sadece yedi günde aldı.
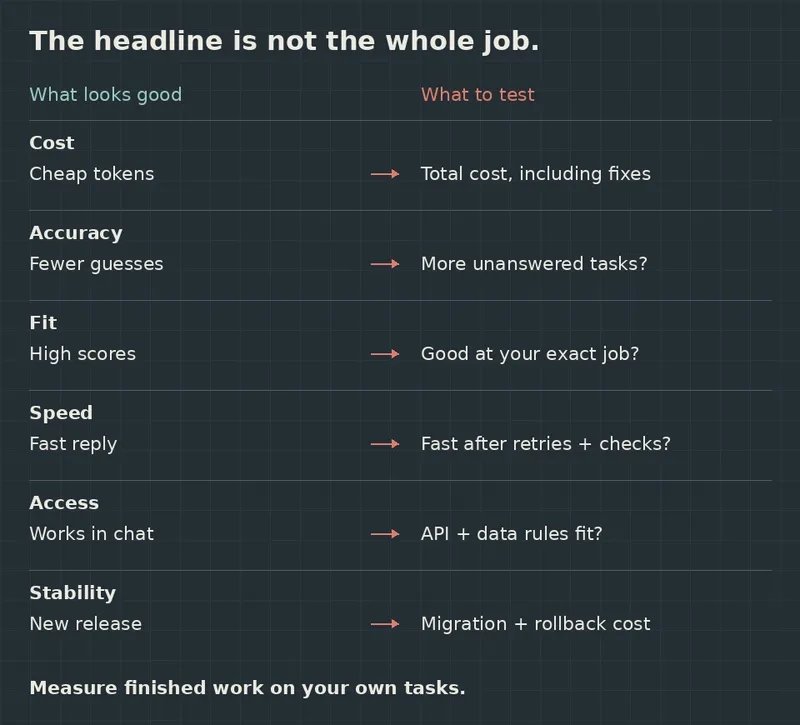
Eğer ürünün avantajı modelin zor problemleri çözmesine bağlıysa bu artık teknik karar değil, iş kararı. Yanlış model seçersen yavaş cevaplar, kırılan marjlar ya da ekibin düzeltmesi gereken hatalar gelir. Puanlar sadece bir kısmı. Gerçek soru şu: hangi model senin kullanım durumunda en iyi sonuç veriyor, en makul fiyata?
Bir modeli test et, gerçek verilerle çalıştır, hızı ve doğruluğu ölç. Puanlar başlangıç noktası, son söz değil. Amrita Thavrani'nin yazısında daha derinlemesine bulabilirsin.
0 yorum