


Bir Fikir, Yedi Model: Yapay Zeka Resim Üreticileri İçin Akıllı Prompt Katmanı
Birden fazla resim modeli ile çalışıyorsan şu sorunu bilirsin: bir modelde mükemmel çıkan prompt, diğerinde berbat olur. Ürün fotoğrafı için yazılı bir prompt bir modelde temiz metni render ederken, diğerinde çorba haline gelir. Video karesinden alınmış gibi görünmesi gereken sahne, birinde yapay ve statik çıkıyor.
Sorun genelde konu değil, vurgulamadır. Her model farklı talimat tarzını ödüllendirir. Bazıları kesin kompozisyon ve metin kurallarını sever, bazıları hareket dilini, bazıları hiyerarşik yapılandırılmış talimatları tercih eder.
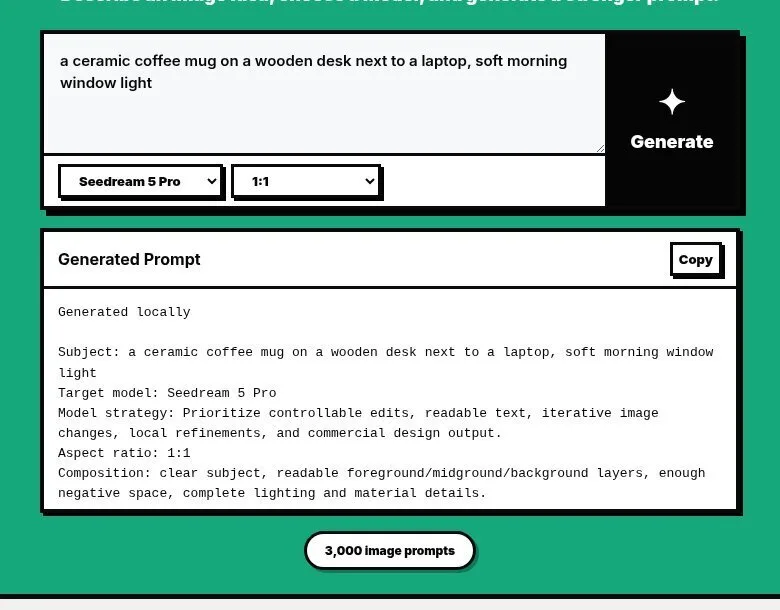
Kaynak yazı, bu sorunu çözmek için "model-strategy katmanı" adlı bir desen sunuyor. Basitçe söylemek gerekirse, kullanıcının istediği ile modelin söylenecek şey arasına küçük bir arama tablosu yerleştiriyorsun. Her model için farklı bir talimat versiyonu tutuyorsun ve runtime'da doğru olanı seçiyorsun.
Praktik tarafı şu: aynı fikri, her modelin tercih ettiği dile çevirmek. DALL-E "detaylı, sinematik, profesyonel" demek istiyorsa, Midjourney "cinematic framing, motion blur, depth of field" gibi kelimeleri daha iyi anlar. Stable Diffusion ise yapılandırılmış, basamaklı talimatları tercih eder.
Yazıda beğendiğim kısım fallback mekanizması: bir API çağrısı başarısız olsa bile, sistem otomatik olarak alternatif modele geçer. Hiçbir şey kırılmaz, kullanıcı fark etmez.
Bu tür katmanlı mimari, sadece resim üretimi için değil, herhangi bir çok-model sistemi için geçerli. Prompt mühendisliğinin geleceği bu tür adaptif yapılarda yatıyor.
0 yorum