


PDF'leri Düzleştirme: RAG için Yapısal Chunking
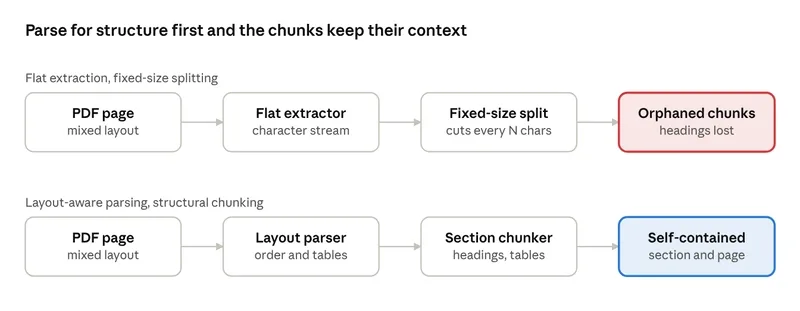
RAG sistemlerinde görünen model sorunlarının çoğu aslında veri hazırlama katmanında yaşanıyor. Bir PDF'i karakterler akışına çevirip her 1000 karakterde kesmek, en iyi embedding modeli ve en güçlü LLM'yi enkazla çalışmaya zorlıyor.
ColPali gibi görsel retrieval modellerinin araştırmaları bunu kanıtladı: metin tabanlı PDF'ler için, embedding modelini değiştirmekten çok daha fazla, veri işleme hattını iyileştirmek retrieval başarısını artırıyor. Yani sorun modelde değil, girdide.
Kavramsal olarak şu şekilde çalışıyor: PDF'nin yapısını (başlıklar, tablolar, sayfalar, okuma sırası) anlaşılır hale getir. Sonra bu yapıya sadık kalarak parçala. Metni rastgele 1000 karakterlik bloklara bölmek yerine, bölümleri, tabloları ve hiyerarşileri koruyarak böl. Token limitleri yalnızca güvenlik ağı olsun.
Pratik fayda nedir? Bir agentta retrieval çağırılırken, yapısal metadata (başlıklar, sayfa numaraları) agenttir filtreleme ve alıntı yapma imkânı verir. Örneğin, bir hukuk belgesi içinde "Madde 5" başlığı altındaki tabloyu çekmek, o tabloyu tam bağlamıyla getiriyor. Düzleştirilmiş metinde bu bağlam kaybolur.
Layout analizi araçları (Docling, Marker, PyMuPDF gibi) PDF'nin görsel yapısını tanıyarak okuma sırası ve tablo sınırlarını koruyor. Bunu yapısal metadata olarak saklaman, sonraki retrieval adımında filtre ve context olarak kullanılabilir hale getirir.
Kısacası: PDF işleminde hızlı ve basit yol hiçbir zaman en iyi yol değil. Yapı korunursa, hem retrieval kalitesi artar hem de agentta kontrol ve doğruluk kazanırsın.

0 yorum